Índice:
- Por que metadados de storage são importantes?
- Quais dados formam essa camada invisível?
- Quem depende dessas informações no dia a dia?
- Como a perda acontece em servidores e NAS?
- O que muda em backups e nuvens?
- Os arquivos continuam íntegros sem esses registros?
- Quais sinais indicam uma falha iminente?
- Como proteger essa estrutura antes do incidente?
- Como restaurar metadados com segurança?
- Quanto custam tempo, risco e recuperação?
- Como escolher uma arquitetura mais segura?
- Como validar o plano antes da emergência?
- Por que essa proteção sustenta a continuidade?
Arquivos podem continuar intactos sem seus metadados, mas usuários perdem nomes, permissões, datas e caminhos. Por isso, alguns volumes ficam ilegíveis para aplicações, mesmo com muitos blocos preservados.
Servidores, backups e nuvens dependem dessas informações para localizar objetos e validar acessos. Além disso, falhas raramente afetam apenas uma pasta, pois índices, atributos e regras costumam compartilhar o mesmo volume.
Uma restauração sem contexto técnico recupera bytes, mas talvez não recupere a operação. Assim, empresas precisam proteger conteúdo e estrutura com políticas distintas, testes frequentes e registros confiáveis.
Por que metadados de storage são importantes?
Metadados de storage são informações que descrevem arquivos, pastas e objetos. Eles registram nomes, permissões, datas, localização, proprietário e organização, por isso orientam o sistema durante cada acesso.
Em um NAS, o sistema consulta esses registros antes de abrir um documento ou listar uma pasta. Um arquivo com conteúdo íntegro ainda pode desaparecer da interface se seu nome, caminho ou inode sofrer corrupção.
Essa diferença explica uma situação frequente em campo. O bloco continua gravado, mas o usuário não encontra o arquivo, o aplicativo perde a referência e o backup não identifica corretamente a versão anterior.
Quais dados formam essa camada invisível?
Um sistema de arquivos reúne vários grupos informativos. Nomes, extensões, tamanhos, datas, atributos, identificadores e permissões descrevem cada item, enquanto índices relacionam pastas, blocos e volumes.
O NTFS usa estruturas como MFT e ACLs. O EXT4 registra inodes e diretórios. O Btrfs acrescenta árvores, snapshots e checksums. Cada arquitetura organiza esses elementos com regras próprias, então uma ferramenta compatível com Windows raramente interpreta um volume Linux sem ajustes.
Também existem metadados específicos para NAS e nuvem. O SMB preserva listas de controle, o NFS trabalha com UID e GID, e serviços S3 usam chaves, tags e políticas. Essa camada torna a busca rápida, mas cria dependências entre plataformas.
Quem depende dessas informações no dia a dia?
Usuários comuns dependem dos metadados para localizar documentos, enquanto administradores dependem deles para aplicar permissões. Além disso, bancos, máquinas virtuais e aplicações colaborativas precisam de datas, travas e caminhos consistentes.
Um servidor de arquivos consulta esses registros em cada abertura. Um software de backup compara tamanho, horário e identificador para decidir quais itens copiar. Já uma nuvem usa chaves e políticas para entregar objetos ao cliente correto.
Em muitos casos, a empresa percebe o problema quando uma pasta compartilhada some ou quando um job ignora arquivos alterados. Raramente o alerta aparece no primeiro minuto, porque o conteúdo ainda ocupa espaço no volume.
Como a perda acontece em servidores e NAS?
Falhas elétricas interrompem gravações no momento mais sensível. Se o sistema atualiza diretórios e índices sem concluir a operação, alguns registros ficam incompletos. Assim, o volume inicia com lentidão, erros ou pastas ausentes.
Discos com setores defeituosos também afetam tabelas internas. Em RAID, a paridade reconstrói blocos em muitos cenários, mas não corrige toda inconsistência lógica. Uma controladora avariada pode agravar o quadro quando grava dados errados em mais discos.
Ransomware acrescenta outro risco. O malware altera nomes, extensões e permissões junto com o conteúdo. Ainda assim, snapshots imutáveis, logs e cópias isoladas reduzem o alcance do incidente quando a equipe reage cedo.
O que muda em backups e nuvens?
Backups não guardam apenas documentos. Eles também precisam registrar ACLs, atributos, links, donos e caminhos. Sem esses elementos, a cópia recupera informação parcial e exige trabalho manual para reconstruir acessos.
Alguns softwares armazenam metadados em catálogos próprios. Outros gravam atributos junto ao arquivo ou dentro do volume. Essa diferença afeta a portabilidade, pois uma cópia feita com SMB pode perder detalhes quando alguém a transfere por um compartilhamento simples.
Na nuvem, a perda pode ocorrer durante migrações entre buckets, contas ou provedores. Objetos continuam presentes, mas tags, versões e políticas desaparecem. Por isso, equipes precisam validar amostras em duas regiões e comparar inventários antes do corte.
Os arquivos continuam íntegros sem esses registros?
O conteúdo pode continuar íntegro sem seus metadados, mas a aplicação talvez não consiga usá-lo. Um banco precisa da ordem correta entre arquivos, uma máquina virtual precisa de seus discos e um sistema corporativo precisa reconhecer seus proprietários.
Ferramentas forenses conseguem localizar sequências conhecidas em blocos livres. Contudo, essa técnica perde nomes, pastas, datas e permissões. A recuperação costuma produzir arquivos isolados, por isso um volume grande exige triagem e conferência.
Documentos simples aceitam reconstrução manual com mais facilidade. Bancos, snapshots e máquinas virtuais exigem consistência transacional. Nesse cenário, alguns arquivos abrem, mas a aplicação falha ao validar índices internos ou dependências.
Quais sinais indicam uma falha iminente?
Erros de entrada e saída surgem antes de muitos incidentes. Lentidão repentina, pastas vazias, permissões alteradas e alertas SMART merecem resposta imediata. Além disso, um NAS que reinicia sozinho pode esconder problemas na fonte, na memória ou na controladora.
Logs mostram a sequência dos eventos. Mensagens sobre journal, inode, checksum, volume sujo ou degradação RAID ajudam a separar defeito físico e erro lógico. Administradores atentos também comparam capacidade usada, quantidade de arquivos e tempo dos snapshots.
Quando o sistema ainda responde, a equipe deve reduzir escritas e copiar evidências. Raramente uma nova reconstrução resolve corrupção lógica, pois cada gravação pode sobrescrever estruturas úteis para a perícia.
Como proteger essa estrutura antes do incidente?
Uma política eficiente combina backup completo, cópias incrementais e retenção suficiente. O modelo 3 2 1 mantém três cópias, usa dois meios e guarda uma unidade fora do local principal. Empresas sujeitas a ransomware acrescentam uma cópia imutável.
Snapshots ajudam na recuperação rápida, mas não substituem backup. Eles compartilham o mesmo conjunto físico e podem desaparecer com o volume. Por isso, o administrador precisa replicar versões para outro NAS, storage ou nuvem.
Checksums validam blocos, enquanto scrubbing procura inconsistências antes da emergência. QNAP com ZFS ou Btrfs aplica recursos úteis nesse cenário, desde que a equipe dimensione memória, retenção e espaço. Tecnologia sem rotina não protege a operação.
Como restaurar metadados com segurança?
A recuperação começa com a preservação do volume original. A equipe deve interromper escritas, registrar os sintomas e clonar discos quando houver suspeita física. Assim, os testes ocorrem sobre uma cópia e preservam evidências.
Depois, o técnico identifica o sistema usado e escolhe uma ferramenta compatível. O Windows trabalha com chkdsk e cópias VSS em situações específicas. Linux usa fsck com cautela. Suites profissionais analisam NTFS, EXT4, XFS, Btrfs e volumes RAID sem alterar a fonte.
Uma restauração segura valida nomes, tamanhos, hashes, permissões e abertura dos arquivos. Alguns terabytes exigem horas ou dias, conforme leitura, quantidade de itens e nível da corrupção. A empresa precisa incluir esse prazo no plano de continuidade.
Quanto custam tempo, risco e recuperação?
O custo cresce quando a equipe tenta soluções improvisadas. Cada inicialização, reconstrução ou formatação pode apagar referências úteis. Além disso, um disco instável pode falhar antes do término da cópia.
Volumes pequenos com snapshots recentes costumam voltar em poucas horas. Ambientes com milhões de arquivos, RAID degradado e permissões complexas exigem mais tempo. Um laboratório especializado cobra conforme mídia, urgência, capacidade e dificuldade lógica.
O impacto financeiro inclui parada, horas técnicas, perda contratual e exposição regulatória. Algumas empresas calculam apenas o preço do disco, mas essa conta ignora usuários parados e dados sem rastreabilidade. Um teste trimestral revela esse risco antes do incidente.
Como escolher uma arquitetura mais segura?
A escolha começa pela carga. Arquivos compartilhados pedem NAS com SMB ou NFS. Bancos e virtualização exigem baixa latência, cache protegido e discos compatíveis. Ambientes críticos também precisam de fontes, interfaces e controladoras redundantes.
RAID 1 simplifica a proteção em dois discos, mas entrega metade da capacidade. RAID 6 tolera duas falhas, embora a reconstrução demore mais. All flash reduz latência, porém aumenta custo e exige análise do TBW conforme a escrita diária.
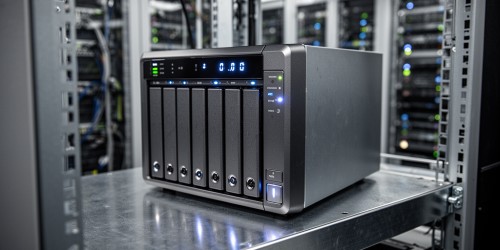
Um QNAP bem dimensionado reúne snapshots, replicação, alertas e cópias externas em uma única administração. Mesmo assim, a equipe precisa separar credenciais, limitar permissões e testar a restauração. Nesse desenho, o equipamento apoia a estratégia, mas não substitui processos.
Como validar o plano antes da emergência?
Um plano confiável define responsáveis, prioridades e metas mensuráveis. O RPO indica quanto dado a empresa aceita perder. O RTO indica quanto tempo a operação pode ficar indisponível. Esses números orientam frequência, retenção e capacidade.
Durante cada teste, a equipe restaura alguns arquivos, uma pasta completa e uma aplicação crítica. Depois, compara hashes, ACLs, datas e dependências. Também registra o tempo gasto, pois uma cópia existente não significa recuperação pronta.
Se o processo falhar, o grupo corrige a causa e repete o ensaio. Frequentemente, a dificuldade aparece em credenciais, licenças ou caminhos alterados. A documentação atualizada reduz dúvidas e melhora a resposta sob pressão.
Por que essa proteção sustenta a continuidade?
Metadados organizam a relação entre conteúdo, usuário e aplicação. Quando essa camada some, buscas falham, acessos quebram e restaurações perdem contexto. Portanto, a empresa precisa tratar estrutura lógica com a mesma atenção dedicada aos discos.
Backups verificados, snapshots, replicação, checksums e permissões bem definidas reduzem vários riscos. Ainda assim, nenhum recurso elimina a necessidade de testes, registros e resposta rápida. A prevenção custa menos quando compara seu valor com horas paradas.
Profissionais e empresas encontram orientações sobre storage, backup e infraestrutura em conteúdos técnicos especializados. Para avaliar um NAS QNAP, revisar sua política ou planejar uma recuperação, fale com a Network Attached Storage pelo WhatsApp (11) 91789-1293. Proteger metadados é proteger a operação.
Não perca mais tempo: fale AGORA com um especialista!
Tire suas dúvidas sobre storage em minutos e descubra como podemos ajudar você ainda hoje. Atendimento rápido e direto pelo WhatsApp.
QUERO FALAR NO WHATSAPP